按意图、功能、安全、数据、性能和测试的顺序审查,要求每条发现都能指到具体位置并复现,再按影响排序处理。
- 学习结果
- 形成一套每次合并或上线前都能执行的审查流程,会用 AI 找问题、会核实 AI 的发现,并按影响决定先修什么。
- 时长
- 2-3 小时
- 难度
- 经验分享
- 核验
- 未核验
正文
让 AI 审查代码,最常见的结果是得到一段很有条理的解释:这段代码做了什么,用了什么设计,看起来“整体质量不错,有几处可以优化”。听完很安心,但真正的问题可能一个也没找到。
代码审查的目的不是听解释,而是找出会出错的地方。这篇讲怎样审查,以及怎样让 AI 在审查中真正帮上忙。
审查的顺序
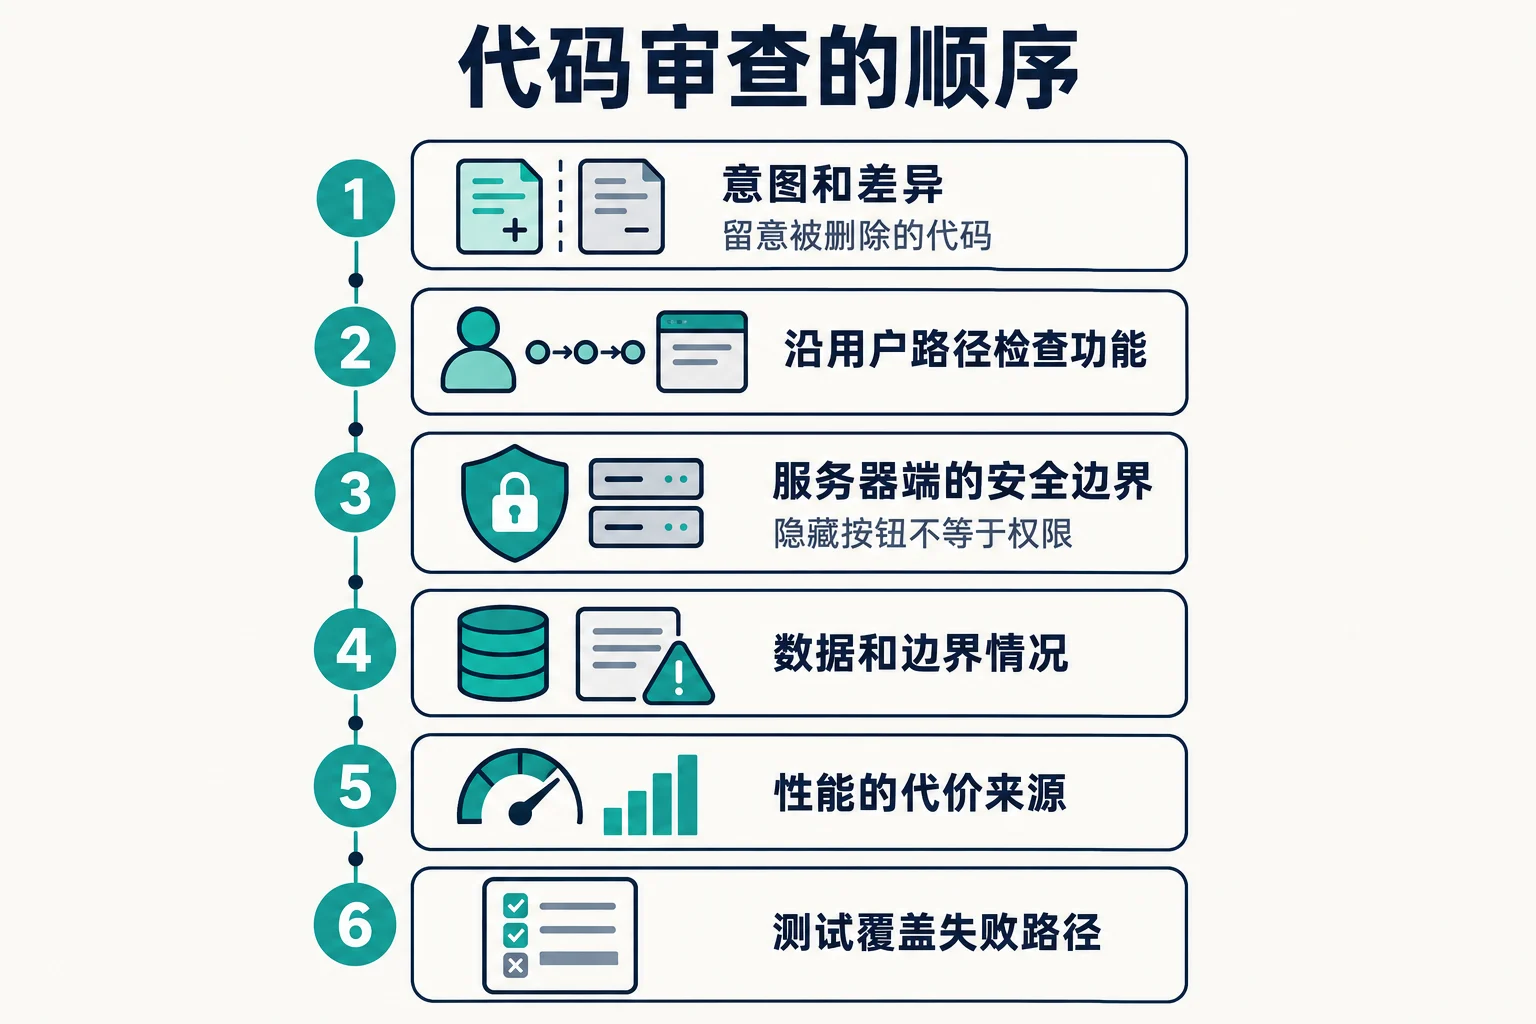
1. 先看意图和差异。 先读这次改动要解决什么问题,再看改动了哪些文件(diff)。只看最终的代码,很容易漏掉被删除的东西:一个权限检查、一行错误处理、一条日志。
2. 沿用户路径检查功能。 列表到详情、提交到保存、付款到开通权限,每条路径都要完整走通。新的按钮是不是真的调用了接口?成功提示是不是等后台确认之后才出现?
3. 安全边界以服务器端为准。 检查权限校验、输入的限制、接口返回了哪些字段、有没有泄露密钥。前端把按钮藏起来不等于没有权限,接口仍然可以被直接调用。用户输入的 HTML 和网址,不能未经处理就渲染到页面或用于跳转。新增的依赖也要看许可证、维护状态和是否真的必要。
4. 数据和边界情况。 空列表、缺少字段、特别长的内容、上一个请求比下一个请求更晚返回。很多实现只在“正常样例”下工作,一遇到这些情况就出错。
5. 性能要说明代价从哪来。 是不是重复请求了同一份数据?每次渲染都做一次大排序?图片没有压缩?一次把几千条数据全部输出?性能问题要指出具体的成本来源,不要为了“优化”先加缓存和并发,缓存还可能带来数据过期的问题。
6. 测试要覆盖失败路径。 一个成功的例子证明不了异步、权限和布局都正确。优先补充保护当前行为的测试,尤其是之前出过问题的地方。
怎样让 AI 帮你找问题
AI 很擅长审查,前提是你给它一个“找问题”的任务,而不是“评价一下”的任务。几个有效的做法:
- 给它完整的上下文:任务目标和 diff,而不只是最终代码。
- 明确要找问题:“请找出这次改动中可能出错的地方,按严重程度排序。不需要解释代码在做什么。”
- 要求可以核实:每条发现都要写出文件和行号、触发条件(什么输入或什么操作下会出错)、预期结果和实际结果。
- 区分确定和推断:要求它标出哪些是读代码就能确定的,哪些是推测,需要运行才能证实。
- 一次聚焦一个方面:分别专门检查一遍安全、一遍边界情况,比一次笼统地审查效果好。
核实 AI 的发现
AI 的审查结论也需要核实。它可能误报:把正确的代码说成有问题;也可能漏报:真正的问题一个字没提。
对每条发现,按它给出的触发条件实际复现一次。能复现的才算确认的问题;复现不了的,要么补充条件再试,要么标为“未证实”。模型认为“可能会失败”的情况,在你实际验证之前只是推断。没有运行过的测试,不能写成“测试通过”。
按影响排序,修根因
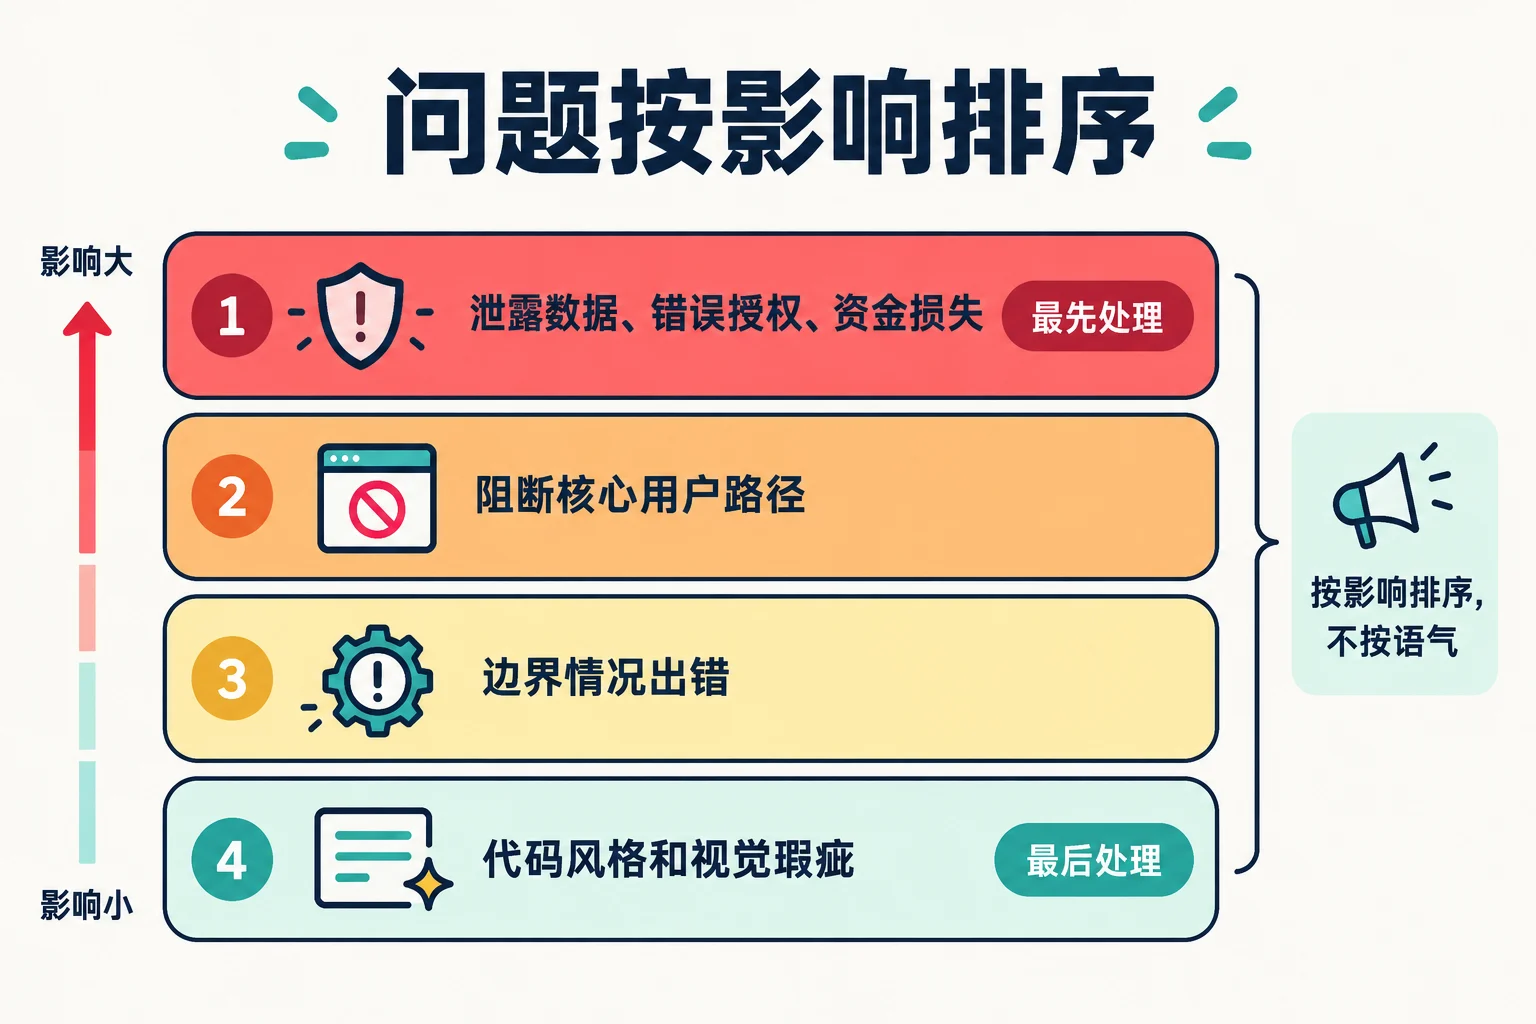
发现的问题按影响排序,而不是按 AI 说话的语气:
- 泄露用户数据、错误开通权限、可能造成资金损失:最先处理,必要时先暂停上线。
- 阻断核心用户路径:比如提交失败、无法付款。
- 边界情况出错:在特定条件下出问题。
- 代码风格和局部视觉瑕疵:最后处理。
确认问题之后,修的是根本原因,并检查所有调用这段代码的地方,而不是只把报错或警告压下去。
最后记录这次审查的结果:哪些问题已经解决,哪些仍然存在,哪些范围没有检查。不要因为审查过一次,就假装整个系统都审计过了。
学习步骤
- 审查前先读这次改动的目标,再看完整的 diff,特别留意被删除的代码。
- 列出这次改动涉及的用户路径,逐条走通。
- 专门检查一遍服务器端的权限、输入限制和返回字段。
- 用空数据、缺字段、超长内容和请求乱序检查边界情况。
- 让 AI 按“文件和行号、触发条件、预期与实际”的格式列出发现,并逐条复现核实。
- 按影响给问题排序,修复根因,并记录已解决、未解决和未检查的范围。
场景拆解
一次“看起来没问题”的改动
小周让 AI 实现了一个功能:用户可以删除自己的工时记录。AI 交付后解释得很清楚,说“已添加删除按钮和接口,并做了权限控制”。
- 看 diff:前端只给记录的主人显示删除按钮;接口根据传入的记录 ID 删除记录。
- 安全检查:他让 AI 专门审查权限。AI 指出:接口没有检查这条记录是否属于当前用户,只要知道别人的记录 ID,就能删除别人的记录。
- 复现:他用两个测试账号实际验证,确认 A 账号可以删除 B 账号的记录。这是一个确认的问题,而且是最高级别。
- 修复根因:在接口里增加“记录必须属于当前用户”的校验,并加了一条测试:用其他用户的 ID 删除时,应该返回无权限。
- 扩大检查:他顺着这个问题,又检查了编辑和导出接口,发现编辑接口也有同样的问题,一起修复了。
“前端隐藏了按钮”被 AI 描述成了“做了权限控制”。真正的权限控制必须在服务器端。这条经验被写进了他的审查清单。
补充材料
思维导图、练习、清单和参考资料可按需展开。
01 思维导图和离线文件
适合读完后下载到自己的知识库里继续整理。
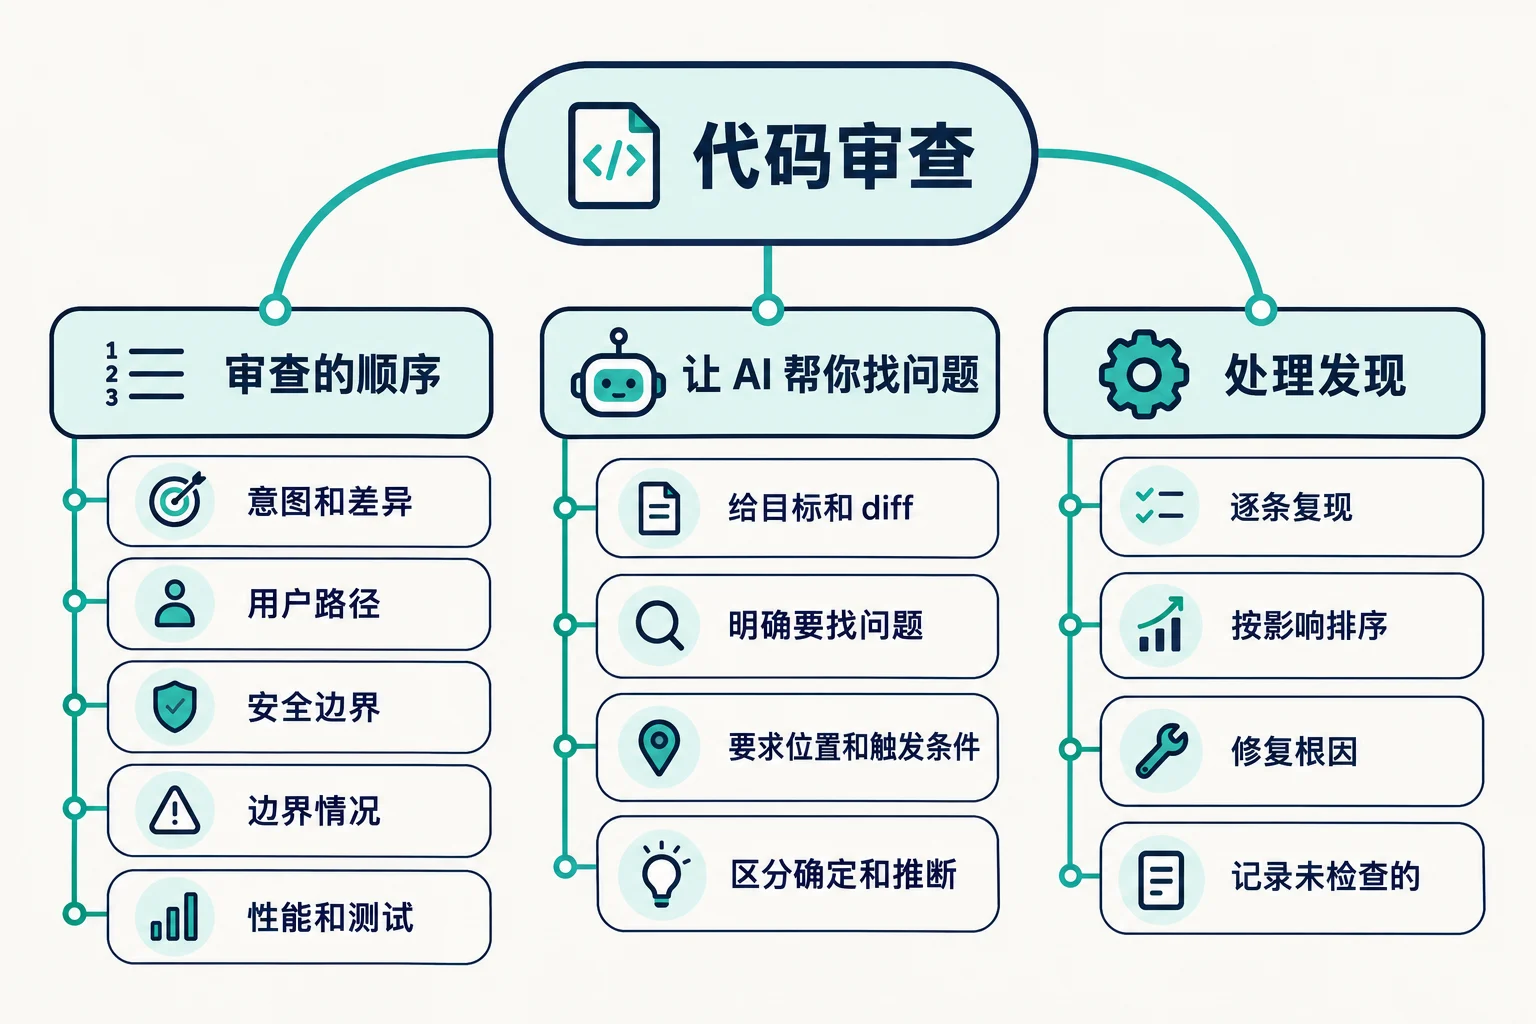
审查的顺序
- 意图和差异
- 沿用户路径检查功能
- 服务器端的安全边界
- 数据和边界情况
- 性能和测试
让 AI 帮你找问题
- 给目标和 diff
- 明确要找问题
- 要求位置和触发条件
- 区分确定和推断
处理发现
- 逐条复现核实
- 按影响排序
- 修复根因
- 记录未检查的范围
02 实践练习
根据文章内容记录自己的判断与依据。
审查一次真实的改动
找一次最近的改动(自己写的或 AI 写的),完成一次完整的审查。
准备材料
- 一次改动的 diff 和它的任务目标。
- 能在本地运行和测试的环境。
练习步骤
01 / 读意图和差异
时间: 20 分钟
操作:
- 读任务目标,再完整阅读 diff。
- 列出被删除或被修改的检查、错误处理和日志。
产出: 一份改动摘要。
检查: 摘要里包含被删除的内容。
02 / 让 AI 找问题
时间: 30 分钟
操作:
- 把目标和 diff 交给 AI,要求它按指定格式列出可能出错的地方。
- 再单独让它审查一遍安全和边界情况。
产出: 一份 AI 发现清单。
检查: 每条发现都有位置和触发条件。
03 / 核实和排序
时间: 40 分钟
操作:
- 逐条复现,标记为已确认、未证实或误报。
- 按影响排序,修复最严重的问题,并补一条测试。
产出: 一份审查记录。
检查: 记录中写明了未检查的范围。
完成检查
- 按顺序审查了意图、功能、安全、数据、性能和测试。
- AI 的每条发现都经过复现核实。
- 问题按影响排序,修复的是根因。
03 清单、模板和关键词
用于项目记录和自查。
审查清单
- 读了任务目标和完整的 diff,留意被删除的内容
- 核心用户路径完整走通
- 服务器端有权限校验,不只是隐藏按钮
- 接口没有返回不该公开的字段
- 用户输入的 HTML 和网址经过处理
- 空数据、缺字段、超长内容、请求乱序都检查过
- 没有重复请求或无界的列表输出
- 失败路径有测试覆盖
- 记录了未检查的范围
让 AI 审查的提示词
任务目标:____
下面是这次改动的 diff。
请找出可能出错的地方,按严重程度排序,不需要解释代码在做什么。
每条请写:文件和行号 / 触发条件 / 预期结果 / 实际结果 / 这是确定的还是推测的。
审查记录模板
改动:
已确认的问题(严重程度 / 位置 / 复现方式 / 修复):
未证实的发现:
误报:
未检查的范围:
关键概念
- diff:这次改动的前后差异
- 用户路径:用户完成一件事经过的完整流程
- 服务器端校验:真正的权限和输入控制
- 边界情况:空数据、缺字段、超长内容、乱序
- 误报和漏报:AI 审查的两种错误
- 根因:问题的根本原因,而不是表面的报错
容易误判
- 只看最终代码,漏掉被删除的检查
- 把前端隐藏按钮当成权限控制
- 让 AI“评价”代码,而不是“找问题”
- 不复现就相信 AI 的结论
- 按语气而不是按影响排序
- 压掉报错,而不是修复根因
04 工具和参考资料
本篇涉及的工具和参考链接。
可参考工具
- GitHub Pull Requests
- Claude Code
- Codex
- Cursor